Ensinando uma máquina a dizer Namárië
No meu primeiríssimo post sobre Quenya (que orgulho!), listei o QuenyaTTS entre as ferramentas que valem a pena conhecer: um sistema de síntese de voz (text-to-speech) para o Quenya, criado por Annie Zhou para a sua dissertação de mestrado de 2024 na Universidade de Groningen.
Achei o projeto muito interessante e pensei que talvez pudesse melhorá-lo testando algumas técnicas diferentes. Primeiro, garimpei algumas edições da Parma Eldalamberon (publicada pela Elvish Linguistic Fellowship) em busca de regras de pronúncia que o código da Annie pudesse estar deixando de fora. Depois, tentei extrair a fonética de uma gravação do próprio Tolkien recitando Namárië, publicada pela Sociedade Tolkien da Romênia.
Este post é sobre o que mudou e sobre o que aconteceu quando coloquei a voz sintética lado a lado com a de Tolkien.
Como funciona o sistema da Annie #
Um sistema de síntese de voz como este funciona em duas etapas:
- Do texto aos sons. Um conjunto de regras transforma o Quenya escrito em símbolos fonéticos (IPA). Elen síla lúmenn’ omentielvo vira
ˈɛlɛn sˈiːla lˈuːmɛnn ɔmɛntiˈɛlvɔ: quais sons produzir e onde cai o acento tônico. - Dos sons ao áudio. Um modelo neural, o IMS-Toucan, da Universidade de Stuttgart, transforma esses símbolos em voz.
O que mudou no código da Annie #
Usei o Claude para encontrar lacunas na forma como o código da Annie converte o Quenya para o Alfabeto Fonético Internacional. As regras foram reescritas e conferidas com o Apêndice E de O Senhor dos Anéis, o Eldamo, vários guias de pronúncia publicados e as próprias notas de Tolkien na Parma Eldalamberon. Alguns exemplos: hr e hl são lidos como r e l simples, w vira v apenas no início da palavra, grafias arcaicas como þ são lidas com o som da Terceira Era, e o acento segue a regra do Apêndice E (nunca na última sílaba; na penúltima se ela for pesada, senão na antepenúltima). Agora cada regra tem um teste.
O projeto original da Annie continha uma cópia modificada de uma versão mais antiga do Toucan. Agora o repositório Quenya-TTS contém apenas as partes do Quenya, e o Toucan entra sem alterações, numa versão fixa. O Quenya é passado ao Toucan como símbolos fonéticos e, como o Toucan nunca ouviu Quenya, ele pega emprestadas as configurações do finlandês, a língua que inspirou o próprio Tolkien.
O Toucan começa a falar logo no primeiro instante do arquivo, então a primeira sílaba saía cortada. A ferramenta agora adiciona uma pequena pausa silenciosa antes do primeiro som. Um efeito colateral foi que o modelo preenchia essa pausa com um ruído, ouvido como um k ou p a mais antes da primeira palavra, então agora essa pausa é silenciada.
Comparando com Tolkien #
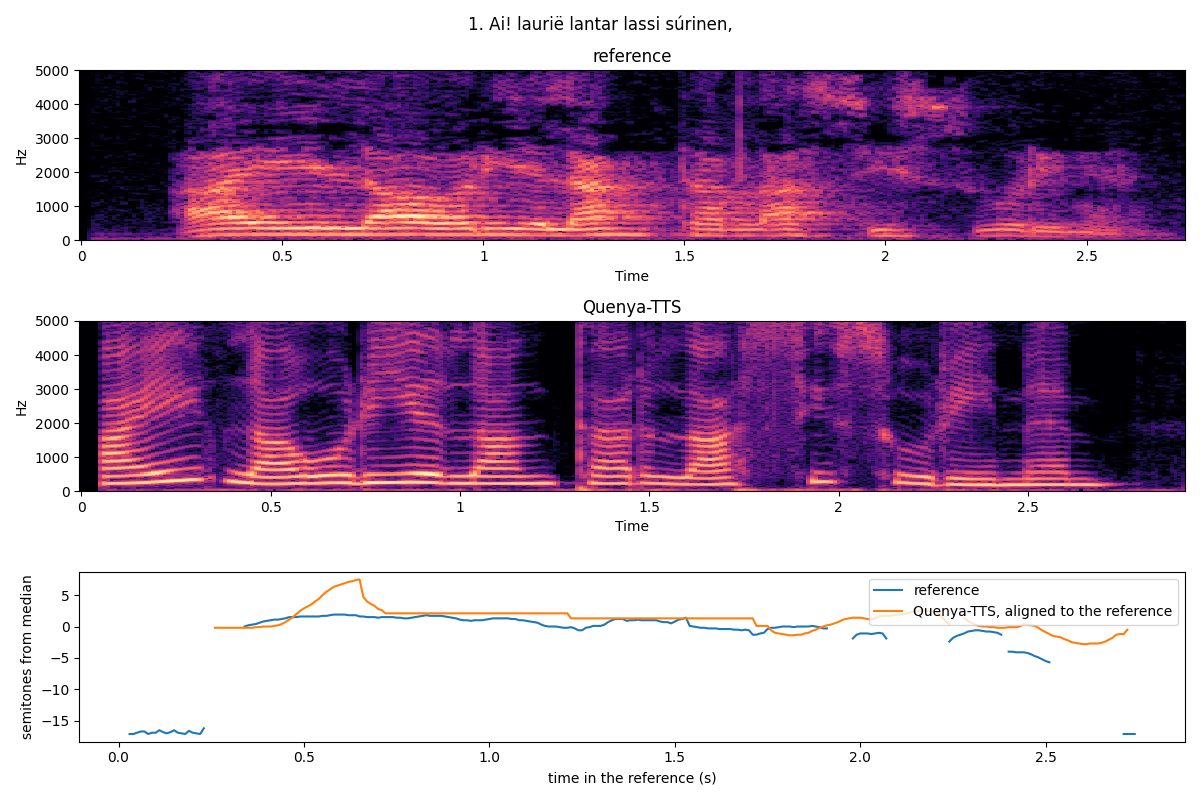
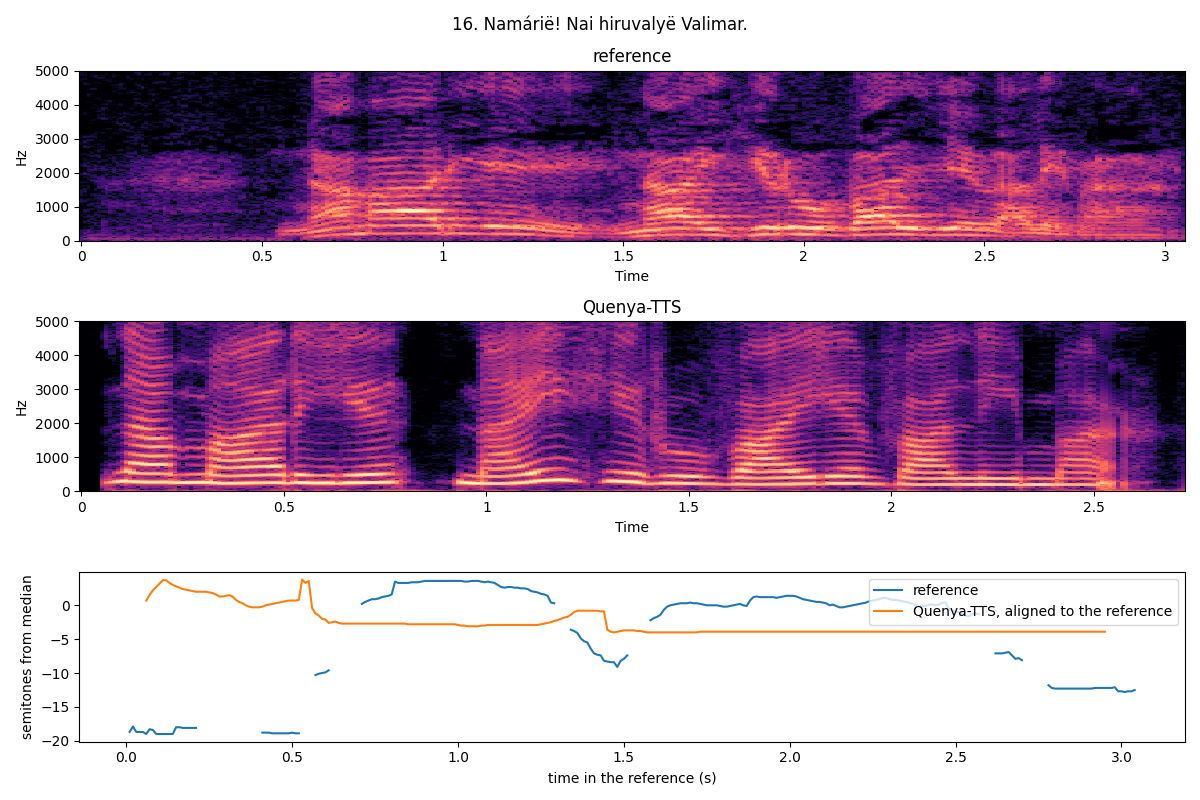
Tolkien gravou a si mesmo recitando Namárië. Escrevi um pequeno script que compara qualquer gravação com a nossa, verso por verso:
- Um reconhecedor de fala multilíngue (wav2vec2 XLSR) anota quais sons ouve nas duas gravações. Comparar isso com o que as nossas regras pedem dá uma taxa de erro de fonemas: quanto menor, mais perto das regras.
- As duas melodias são desenhadas uma sobre a outra, em semitons.
Há duas ressalvas. O reconhecedor não é perfeito; por exemplo, ele ouve muitos e abertos como fechados. E a fita de Tolkien é antiga e cheia de ruído. Então os números são uma referência, não uma nota.
Depois que a gravação de Tolkien foi cortada corretamente nos versos de Namárië, rodei o script três vezes, e cada rodada corrigiu o que a anterior mostrou:
| Rodada | O que mudou | Taxa de erro (nossa) | Duração vs Tolkien |
|---|---|---|---|
| 1 | primeira comparação | 27% | 0,86 |
| 2 | mais lenta, melodia mais plana | 24% | 0,99 |
| 3 | pausa silenciosa antes da primeira palavra | 22% | 0,97 |
A própria gravação de Tolkien tem 33% em relação às nossas regras, mas, ao ouvi-la, dá para perceber que o reconhecedor não capta alguns dos seus fonemas. Correções manuais provavelmente melhorariam essa taxa, mas o objetivo deste exercício era encontrar as grandes lacunas de pronúncia para corrigir no código da Annie.
O que eu aprendi #
As regras concordam com Tolkien. Onde o reconhecedor ouve Tolkien com clareza, ele diz o que as regras preveem. A única diferença interessante é o ly, como em ilyë e hiruvalyë: as regras usam um único som, mas na voz de Tolkien o reconhecedor ouve dois fonemas, l seguido de y. As fontes deixam as duas leituras em aberto (em Tengwar, ly é uma única letra com dois pontos embaixo), então mantive o som único.
Os erros restantes provavelmente são do modelo. Não tenho acesso ao modelo treinado da Annie, e as poucas gravações de Quenya disponíveis não bastam para treinar um novo (falo disso mais abaixo). Os principais problemas que restam são:
- o modelo não consegue produzir o l palatal, então ilyë sai como “ihe”;
- o r final é fraco e é ouvido como l (Valimar, tellumar), quando deveria ser vibrante;
- o d de undulávë desliza para um b, entre dois u arredondados.
Falta voz #
Para ver até onde as gravações existentes levariam o modelo, fiz um ajuste fino (fine-tuning) do Toucan no Kaggle com cerca de oito minutos de leituras em Quenya, apenas para testes privados. Depois de 5.000 passos de treino, o modelo soava melhor nas frases que tinha ouvido e pior nas que não tinha: um caso clássico de sobreajuste (overfitting). Regras melhores não resolvem isso. O que o modelo precisa é de horas de Quenya limpo, de preferência de uma única voz.
Próximos passos #
Primeiro, a minha voz. Escrevi um roteiro de gravação com 2.500 frases, cerca de 90 minutos de fala divididos em 25 sessões: primeiro as frases da lição 1 do Ma Quetilyë Quenya?, depois frases atestadas e, por fim, frases construídas com palavras atestadas no Eldamo. Gravo em casa com uma pequena ferramenta que também toca a versão sintética de cada frase. O mesmo reconhecedor que usei com Tolkien agora confere as minhas gravações, e é uma lição de humildade: ele me pega no nw, no ny, no au e no qu inicial mais vezes do que eu gostaria.
Depois, os voluntários. Um pequeno site está quase pronto, onde voluntários poderão ler sessões do mesmo roteiro direto no navegador. Um revisor ouve cada sessão e a aceita ou pede que frases específicas sejam lidas de novo. Uma voz só entra no treino quando tiver áudio aceito suficiente.
Mudei de ideia sobre uma coisa desde que escrevi este post: as gravações não serão publicadas sob uma licença aberta. Elas servem apenas para treinar o modelo. Cada voluntário pode baixar as próprias gravações e fazer o que quiser com elas, e pode exportar ou apagar os seus dados a qualquer momento, como exige o GDPR (o equivalente europeu da LGPD). O site, o armazenamento e o treino rodam todos em servidores na União Europeia, em Luxemburgo e em Portugal.
Uma voz que não é de ninguém. Um modelo treinado com a voz de alguém vai soar como essa pessoa. Por isso, o modelo que eu publicar vai falar com uma voz misturada, que não pertence a nenhum voluntário. Cada arquivo de áudio que ele produzir vai levar uma marca d’água inaudível indicando que é sintético, como pede o AI Act da União Europeia, e a sua licença vai proibir o uso para imitar uma pessoa real.
Se você quiser emprestar a sua voz, veja a issue de vozes voluntárias. Vou escrever um novo post quando o modelo tiver aprendido a falar com a minha voz.
Se tiver qualquer comentário, me avise.
Namárië | See you | Bis geschwënn | Até mais | À bientôt