Otimizando a tomada de decisão com um motor de regras baseado em Trie Tree: um relato de experiência
Na Pictet Technologies, meu time depende muito de modelos de decisão. Esses modelos permitem que nossos analistas de negócio insiram regras de Compliance diretamente nos sistemas, com o mínimo de intervenção dos desenvolvedores. Quando entrei na empresa, usávamos tanto o Drools quanto o Camunda. No entanto, enfrentávamos sérios problemas de memória e de desempenho, especialmente com o Camunda, o que me levou a buscar alternativas.
Para quem não conhece essas soluções, as duas são fornecedoras de motores de regras (rules engines). E um motor de regras é um sistema de software projetado para processar e executar conjuntos de regras de negócio. Essas regras fornecem decisões automatizadas a partir de um conjunto de entradas. Resumindo, um motor de regras é um interpretador de if/else bem sofisticado. Para mais detalhes, sugiro que você siga este link.
O primeiro desafio que encontrei foi com o arquivo de modelo e notação de decisão (ou DMN). Aliás, o DMN é o formato “padrão” que tanto o Drools quanto o Camunda implementam. Embora seja relativamente fácil de entender, é impossível carregar o mesmo arquivo nos dois fornecedores. Outro ponto é que a maioria dos nossos casos são tabelas de decisão simples. Se não fosse pela quantidade de regras, seria mais simples codificar as regras de negócio diretamente em Java.
Mas o problema mais crítico desses motores era o desempenho. Nossos serviços baseados em DMN tinham dificuldade para lidar com uso concorrente. Mesmo em requisições isoladas, o processamento demorava mais do que nossos clientes esperavam.
Começando a jornada #
Inicialmente, avaliei soluções alternativas, mas, no fim das contas, Drools e Camunda eram os grandes nomes da área quando comecei esses estudos. E os dois eram, e continuam sendo, fáceis de usar e de integrar, gratuitos e oferecem ferramentas para manter os arquivos DMN.
O passo seguinte foi usar um banco de dados, onde as regras poderiam ser armazenadas e facilmente acessadas por meio de queries. Porém, essa abordagem rapidamente resultou em um desempenho ruim.
Por fim, comecei a explorar a possibilidade de desenvolver a minha própria solução, o que me levou a pesquisar. Foi aí que descobri a Trie Tree, uma estrutura de dados bem básica que organiza palavras em prefixos compartilhados. Por favor, siga este link para entender em detalhes como a Trie Tree funciona. Há também esta ferramenta de visualização para você se familiarizar com essa estrutura de dados.

Imagem reutilizada do GeeksForGeeks
Olhando com mais atenção, percebi que, tratando cada entrada de uma regra como um caractere de uma string, a Trie Tree é uma boa solução para um motor de regras. O desafio quando comecei a desenvolvê-la foi o valor “ANY”, que aceita qualquer valor de entrada para um determinado campo. Para contemplar isso, foi necessário propagar corretamente os filhos do nó ANY para todos os irmãos, e vice-versa, garantindo que o ramo correto pudesse ser percorrido.
Outro desafio na implementação da Trie Tree foi o disparo de múltiplas regras, implementado pelos dois fornecedores. Para conseguir isso com a Trie, o nó folha deve conter uma coleção ordenada de IDs de regras — o mecanismo de ordenação depende da Hit Policy escolhida pelo desenvolvedor. Na maioria dos nossos casos, usamos a hit policy FIRST, que retorna o primeiro elemento da coleção ordenada pelo ID da regra.
Revisando a solução #
O desempenho geral foi excepcional, como mostrado mais adiante. No entanto, o consumo de memória continuava alto. Depois de estudar outras implementações de Trie Tree — a Radix Tree é um exemplo —, desenvolvi um algoritmo para eliminar os nós ANY sem irmãos, já que eles são sempre o ramo padrão. Essa abordagem reduziu algumas subárvores a um único nó.
Depois de mais testes, percebi que o número de nós fica significativamente menor se eu ordenar as entradas de forma adequada. Esse é um problema computacionalmente complexo, mas, felizmente, existe uma abordagem simples para evitar testar todos os cenários possíveis: basta ordenar as entradas de acordo com a quantidade de valores ANY que cada uma tem. Em um serviço específico, essa técnica nos permitiu reduzir o número de nós de 30 mil para 1,5 mil.
Preparando este artigo #
Primeiro, transformei essa implementação de Trie Tree em um projeto open-source, que chamei de Praecepta (Regras, em latim), para que qualquer pessoa possa experimentá-lo. Depois, adicionei três módulos a ele, com uma tabela de decisão baseada em um cenário real (com os valores de entrada e saída mascarados). Cada módulo usa um framework diferente: Praecepta, Camunda 7 e Kogito (a solução mais nova da Kie para a Cloud).
Usei SpringBoot 3.0.2, GraalVM 22 (modo JVM), em um MacOS 2,6 GHz 6-Core Intel Core i7, rodando 1000 usuários durante 5 minutos. A ideia era testar como o consumo de memória e o uso de CPU evoluem. Abaixo, comparei o footprint dessas três soluções. Coletei o total de requisições, o throughput, o consumo de memória e o uso de CPU usando o VisualVM e o Gatling.
Superando Kogito e Camunda #
Os números não mentem!
| Solução | Requisições (total) | Throughput (média/s) | Memória (pico) | CPU |
|---|---|---|---|---|
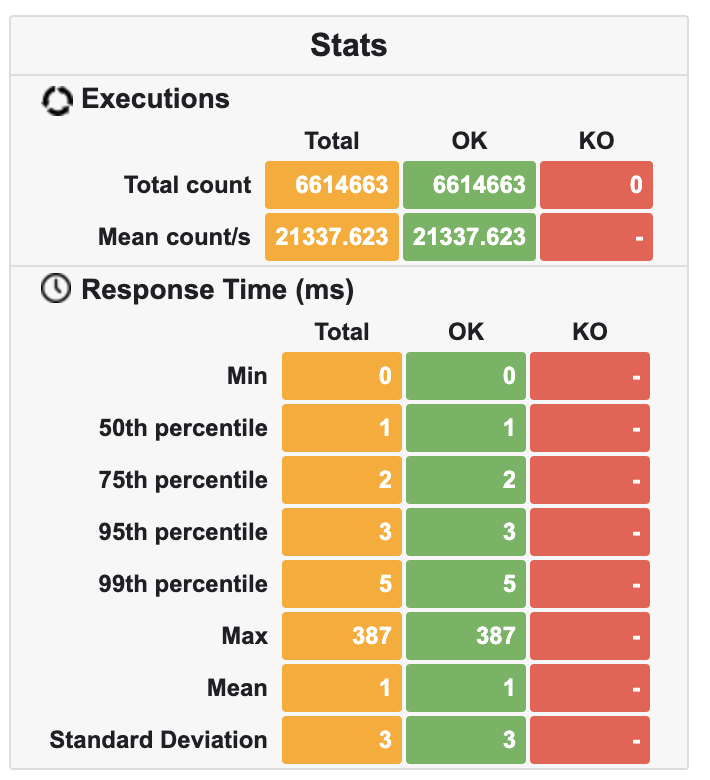
| Praecepta | 6.614.663 | 21.337 | ~100MB | ~25% |
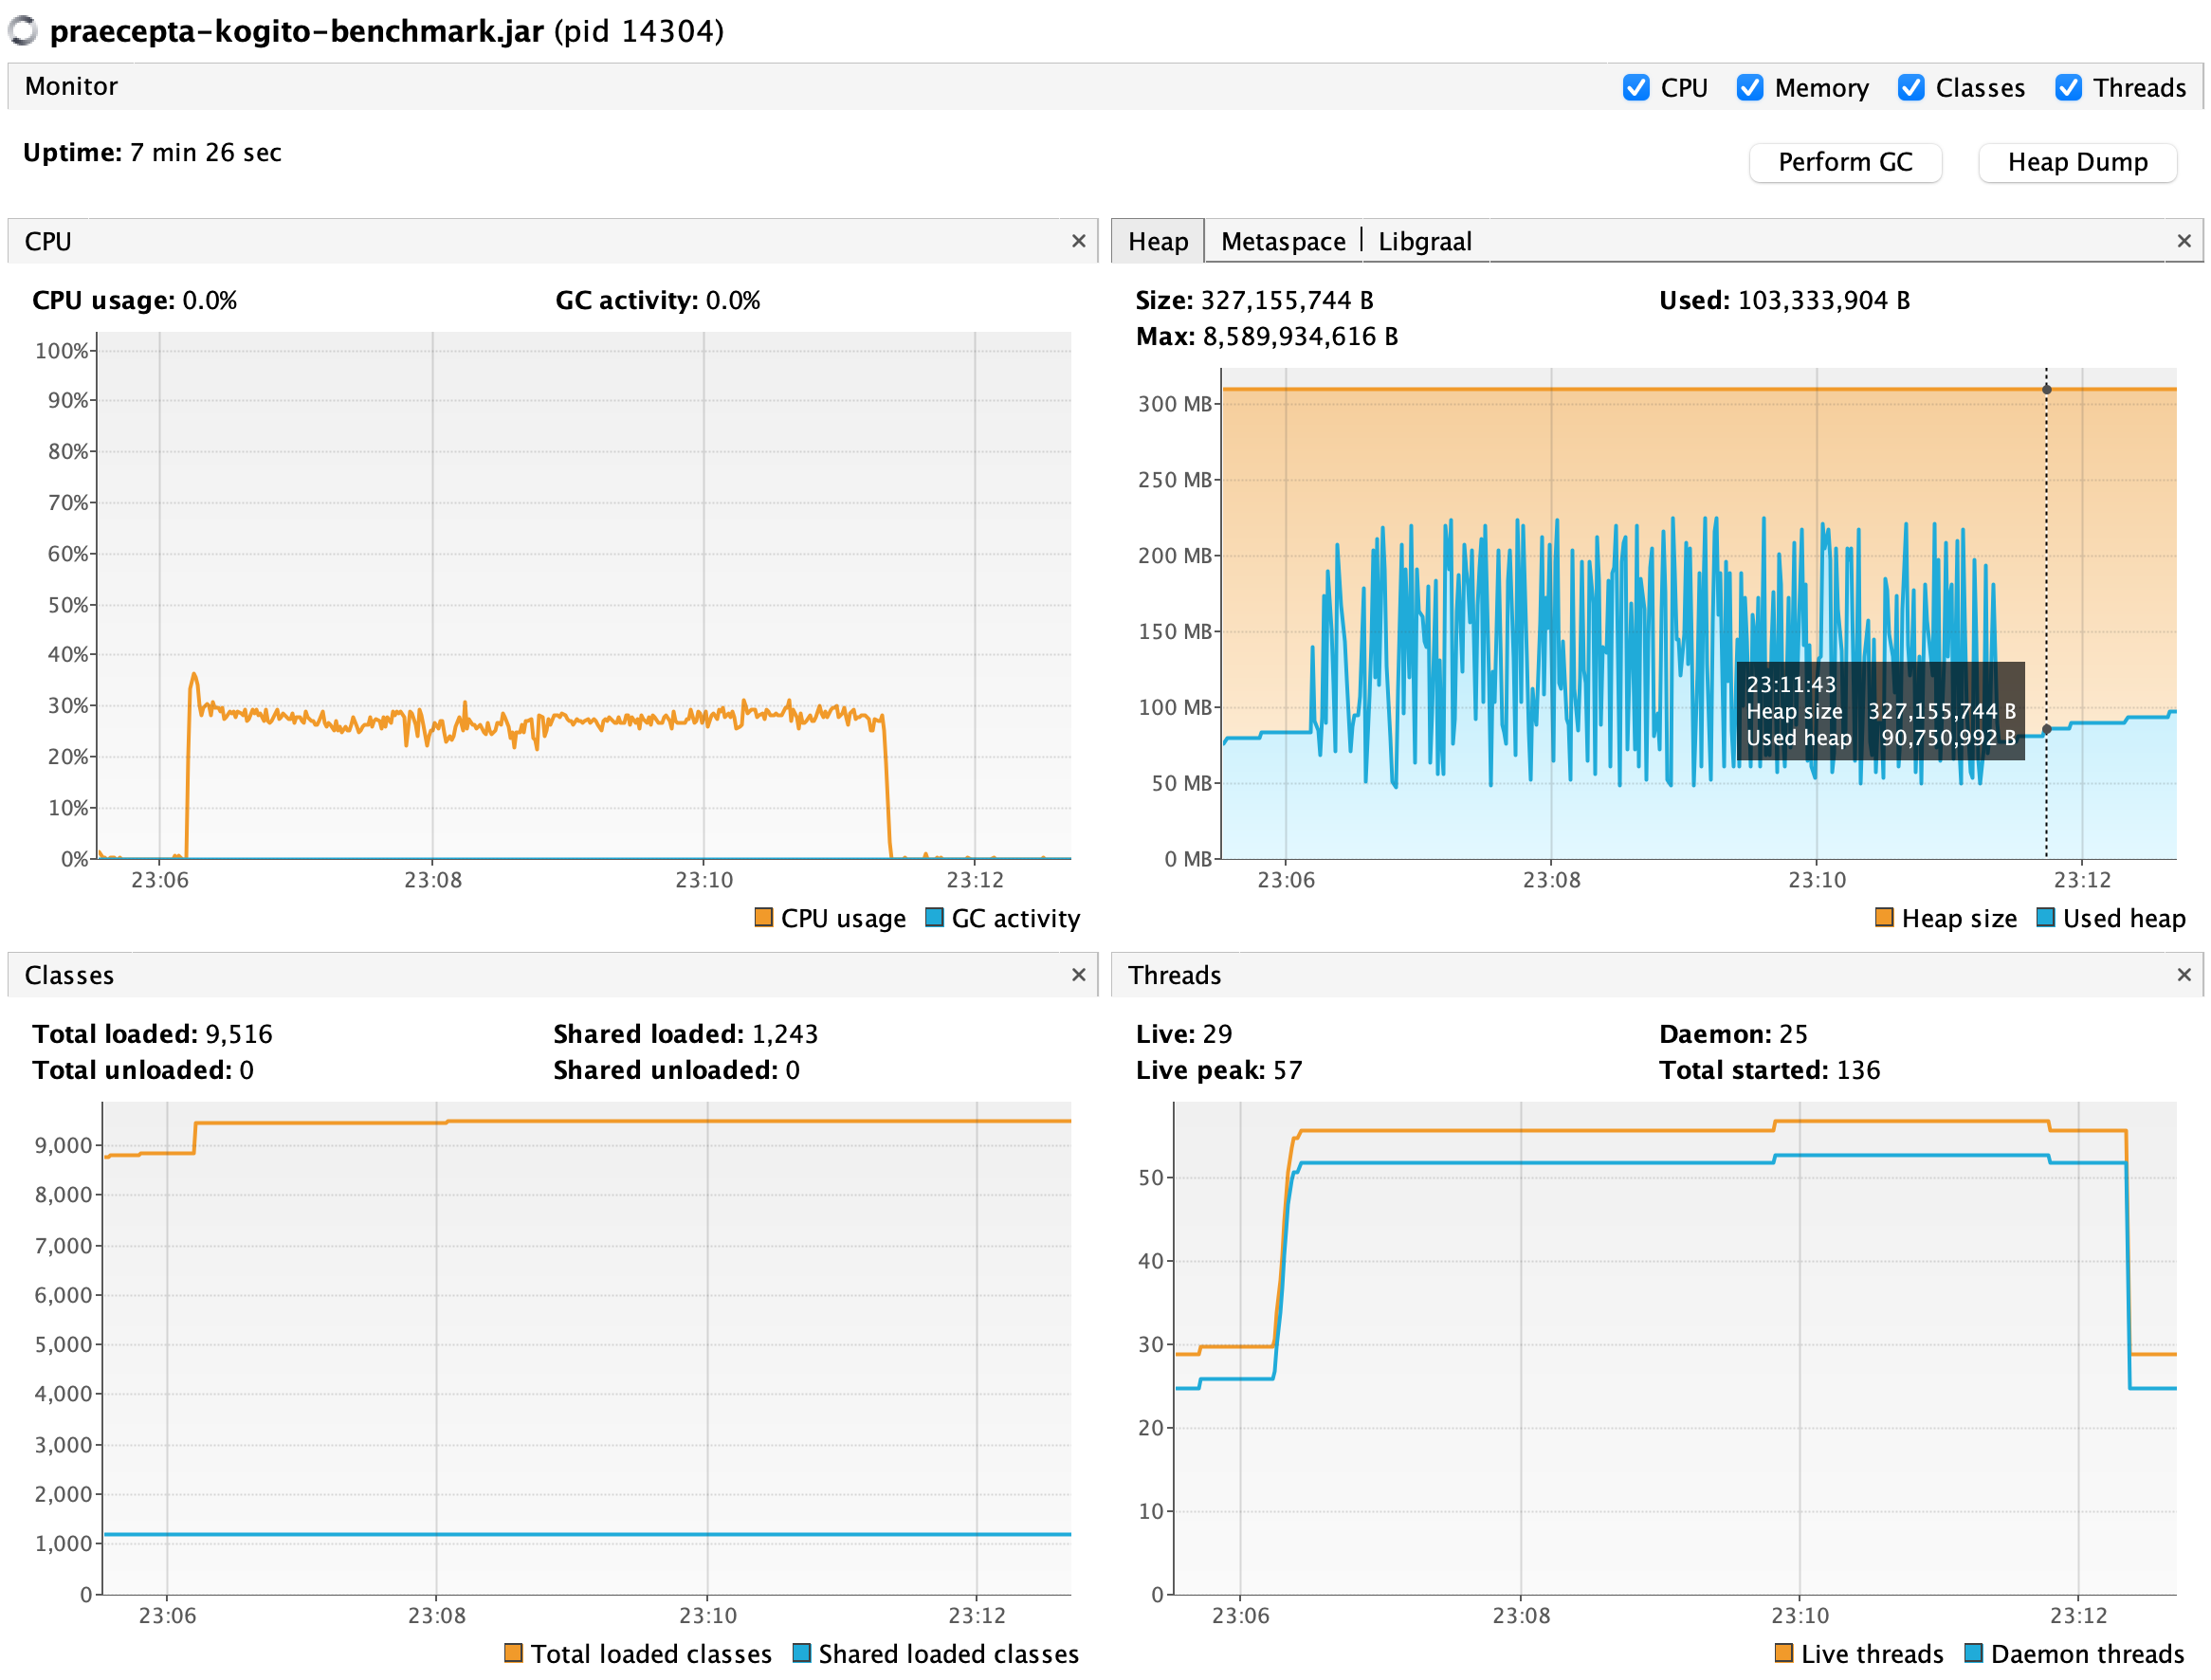
| Kogito | 3.615.549 | 11.663 | ~225MB | ~30% |
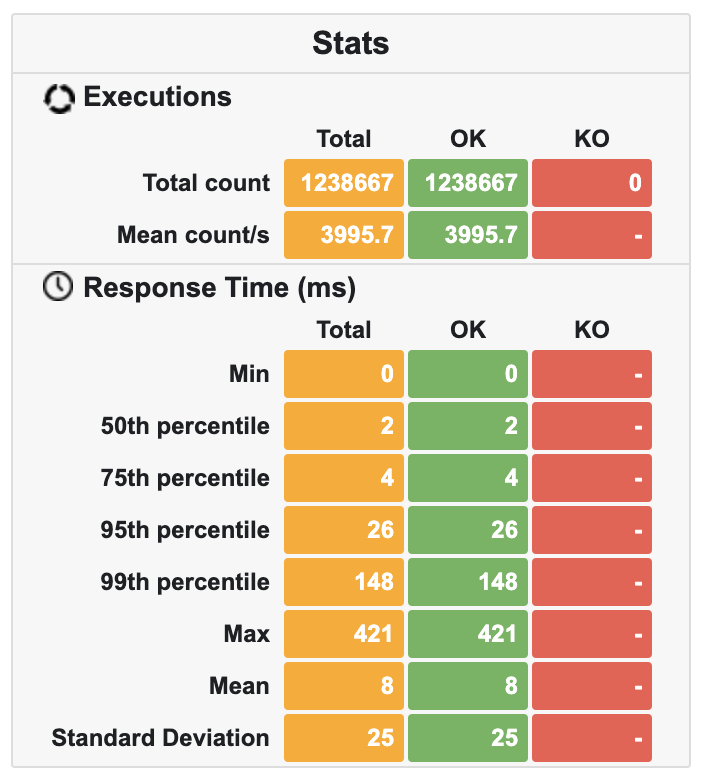
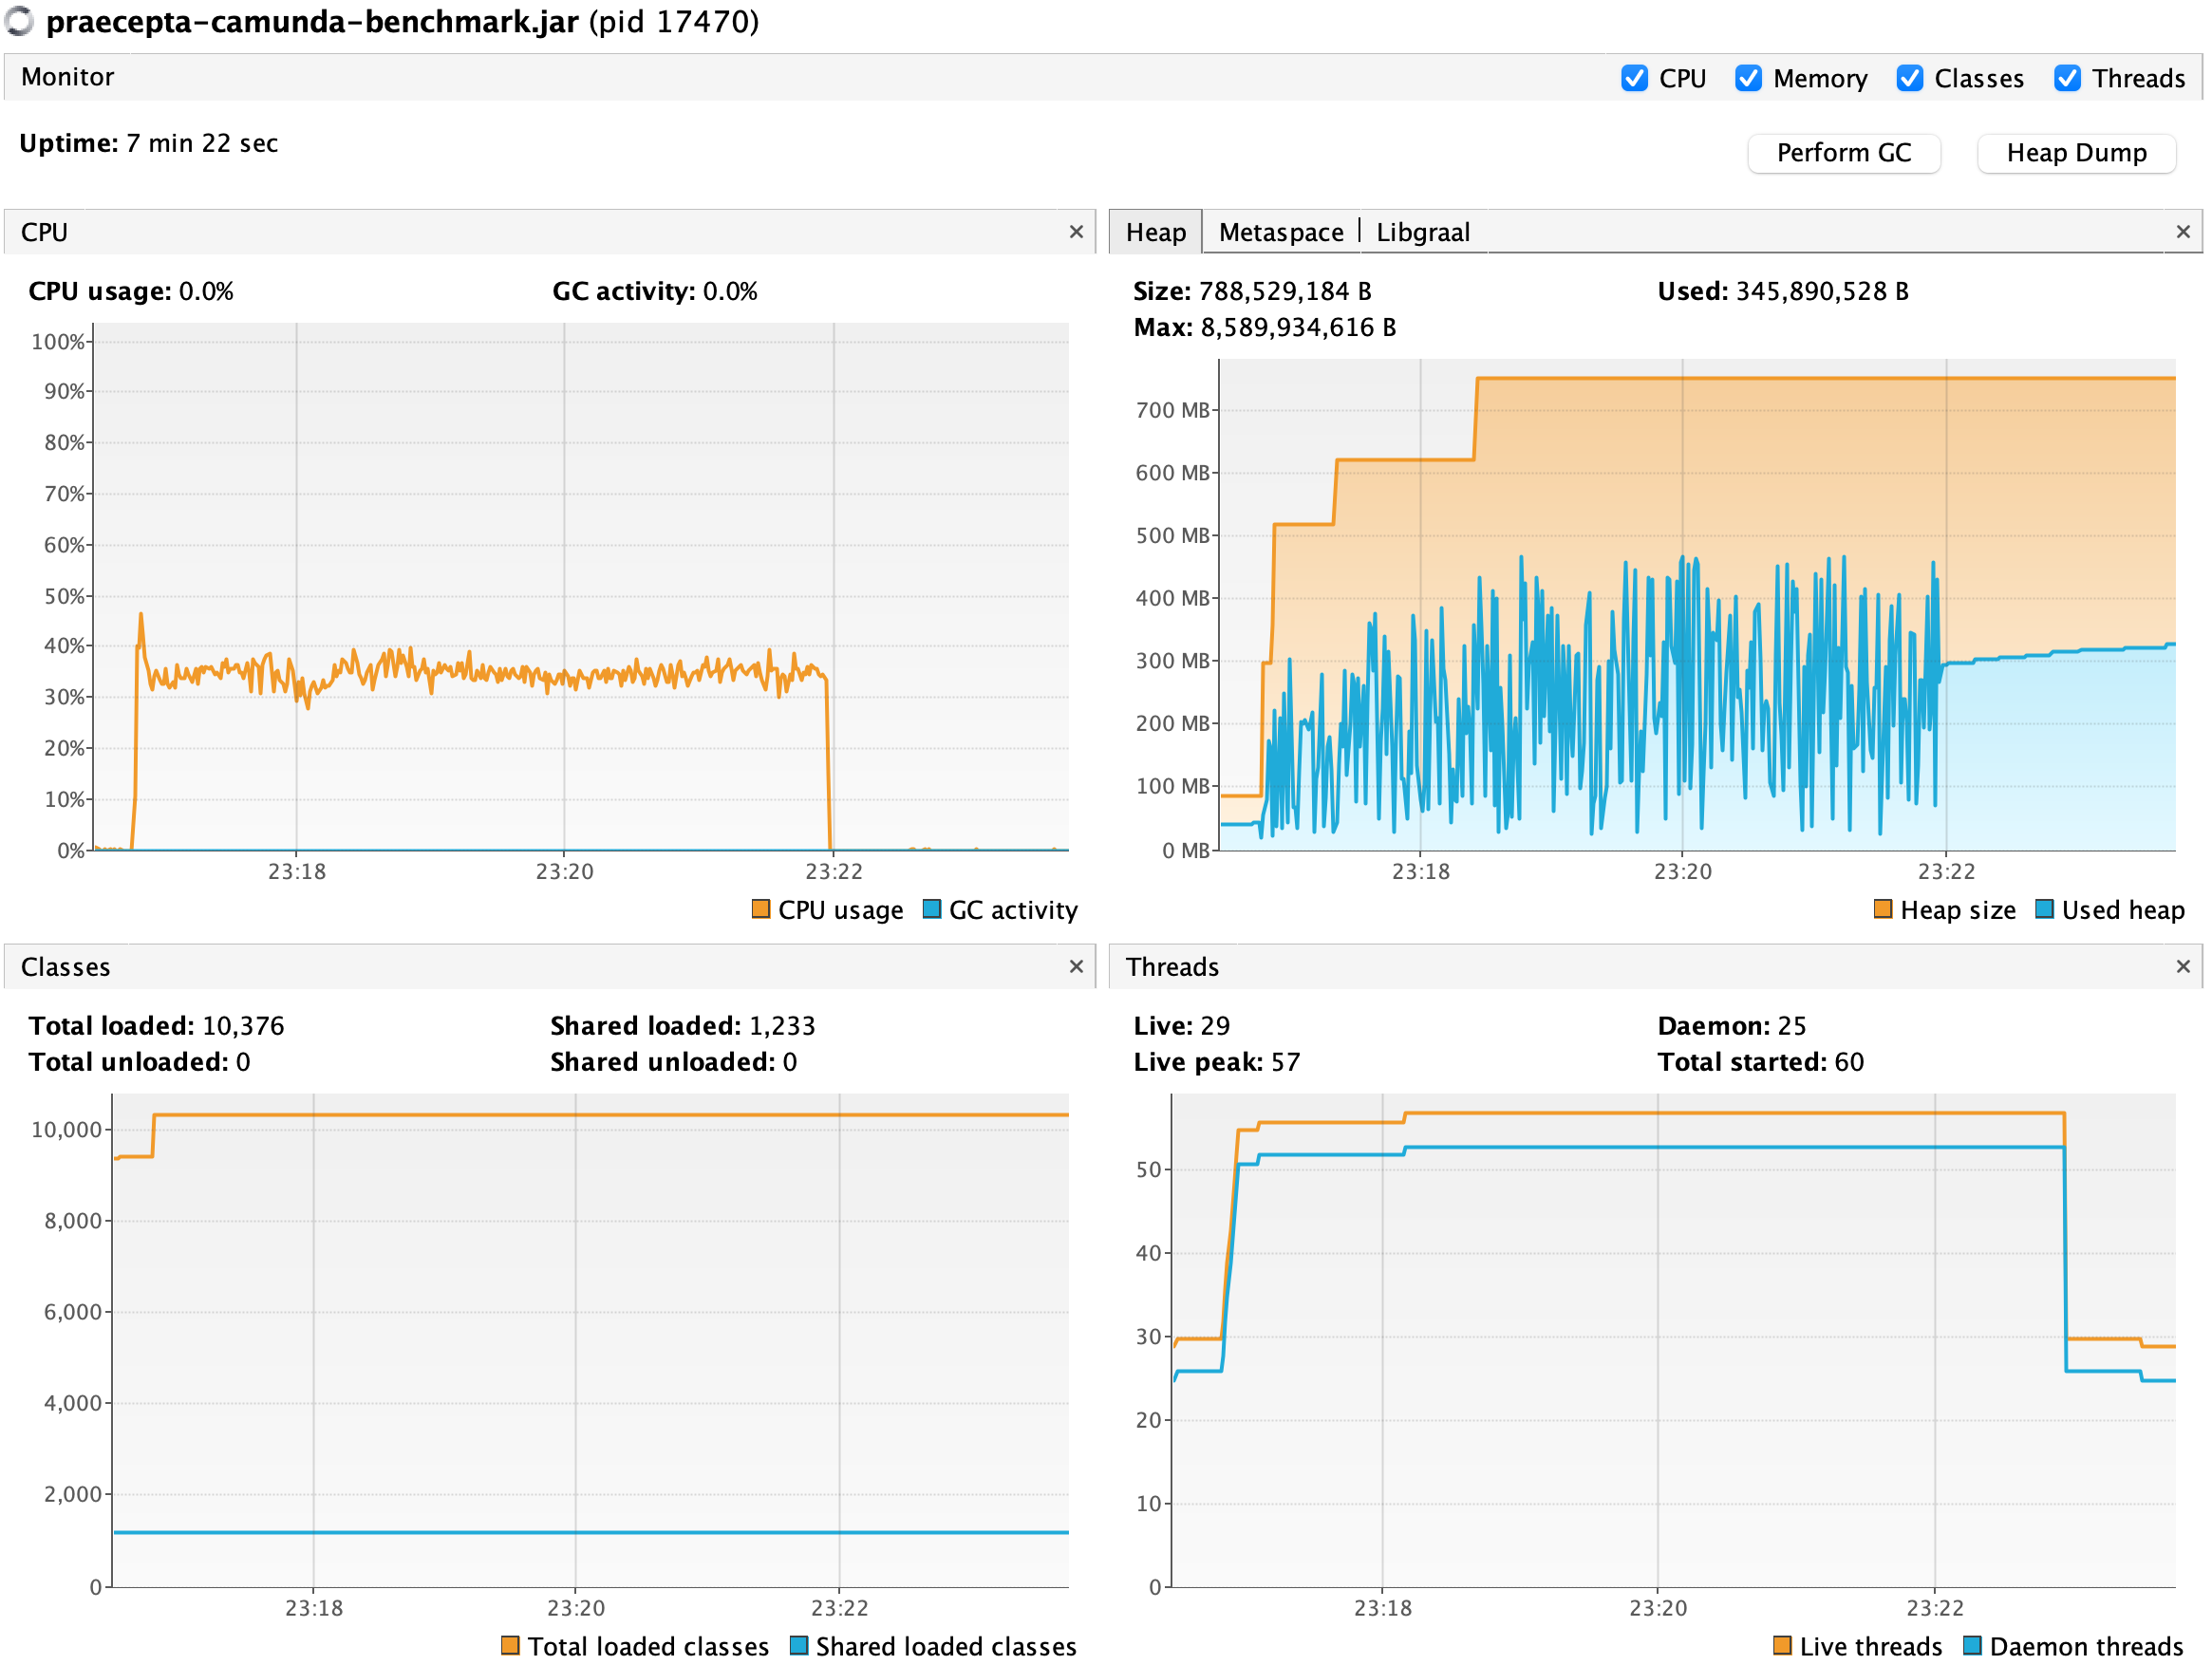
| Camunda 7 | 1.238.667 | 3.995 | ~450MB | ~35% |
Conclusões #
Você pode conferir os resultados abaixo.
Infelizmente, o Camunda 7 não se saiu bem. Ele foi 3x mais lento e 2x maior que o Kogito. Este último se mostrou aceitável diante dos números, mas, ainda assim, usou o dobro de memória do Praecepta. O Praecepta, por outro lado, manteve a memória de forma estável abaixo de 100MB, com baixo uso de CPU e um throughput 2x maior em comparação com o segundo colocado.
A conclusão não é que o Kogito ou o Camunda sejam ruins. Sempre depende do que planejamos e queremos para o nosso sistema. Se você tem um cenário muito mais complexo, o Kogito ou o Camunda podem atender melhor às suas necessidades, mas, antes, você deveria avaliar outras soluções antes de comprar/usar um deles.
Para o nosso time, uma estrutura de dados simples teve um impacto imensamente positivo. Conseguimos entregar microsserviços com um footprint menor e uma disponibilidade muito maior.
Para mim, foi uma excelente oportunidade de usar a minha formação em ciência da computação e aprender coisas novas.
Resultados #
Praecepta - TrieTree #

Kogito #

Camunda #
See you | Bis geschwënn | Até mais | À bientôt